TLDR: Ich wollte wissen, ob meine Kampagnen die richtigen Leads bringen — ohne 15 Tage auf den Vertrieb zu warten. Also stuft eine AI jeden Lead sofort nach ICP-Fit ein: 55 % Primary gegenüber 56 % beim Vertrieb. Heute läuft die halbe Firma auf dieser Einstufung.
Mein Problem war banal: Ich schalte Kampagnen und weiß nicht, ob die Leads etwas taugen.
Die Antwort darauf kommt normalerweise vom Vertrieb — frühestens. Zwischen Demo-Anfrage und Demo done liegen rund 15 Tage. Und ein erheblicher Teil der Leads bekommt überhaupt nie ein Gespräch: kein Termin, keine Rückmeldung, keine Bewertung. Für die gibt es nie eine Antwort.
Also habe ich mir die Daten selbst gebaut: ein ICP-Radar, das jeden eingehenden Lead sofort einstuft — Primary, Secondary, Non-Relevant oder unknown, jeweils mit Begründung.
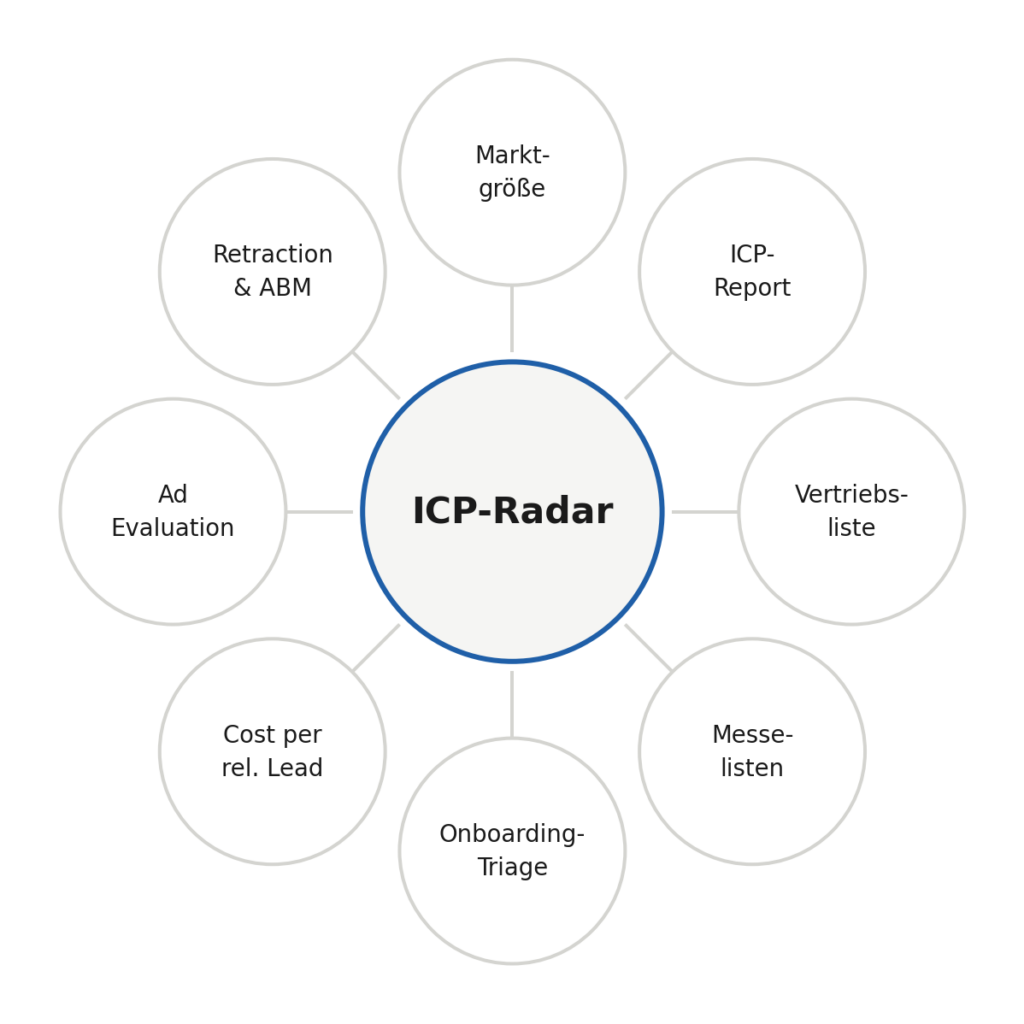
Gebaut habe ich es für meine Kampagnen. Inzwischen läuft es in Prozessen, mit denen Marketing nichts zu tun hat: Marktgröße für die Geschäftsführung, Anruflisten für den Vertrieb, Messevorbereitung.
Warum das über Marketing hinaus wirkt
Beim Bauen wurde klar: Die Frage „wer gehört zu unserer Zielgruppe?“ beantwortet in den meisten Firmen jede Abteilung anders — Vertrieb per Bauchgefühl, Marketing per Kampagnenstruktur, Geschäftsführung per Strategiefolie.
Drei Definitionen, nie abgeglichen. Die Folgen sind messbar:
| Ohne gemeinsame Definition | Kosten |
|---|---|
| Lead-Relevanz erst nach Sales-Feedback | 4+ Wochen blindes Budget pro Kampagne |
| Marktgröße ist eine Schätzung | keine belastbare Durchdringungsrechnung |
| Vertrieb priorisiert nach Gefühl | Anrufzeit auf falschen Firmen |
| Irrelevante Leads fließen als Conversion in Google Ads | Algorithmus optimiert auf die falsche Zielgruppe |
Macht man die Definition zu einem ausführbaren Artefakt — einer Regeldatei, die jede Firmenliste durchläuft — verschwinden alle vier Posten auf einmal.
Was der Skill liefert
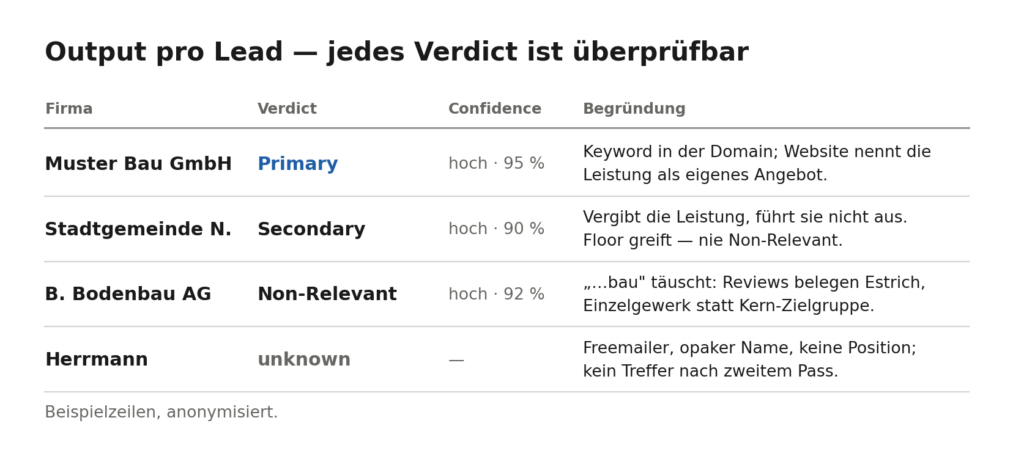
Input pro Lead: Firmenname · Position · E-Mail. Output: ein Verdict, eine Confidence, eine Zeile Begründung mit Quelle.
| Verdict | Bedeutung | Was damit passiert |
|---|---|---|
| Primary | Kern-Zielgruppe | Sales-Priorität, ABM-Liste, Conversion bleibt |
| Secondary | branchennah, kauft nachweislich | eigener Funnel, nie aussortiert |
| Non-Relevant | falsche Branche | Conversion wird aus Google Ads zurückgezogen |
| unknown | geprüft, nicht entscheidbar | manuelle Prüfung, nie geraten |
Die Begründungsspalte ist keine Deko — sie ist die einzige Möglichkeit, die Maschine zu reviewen. Ein Verdict ohne nachvollziehbare Quelle kann man nicht widerlegen.
Was das im Unternehmen löst
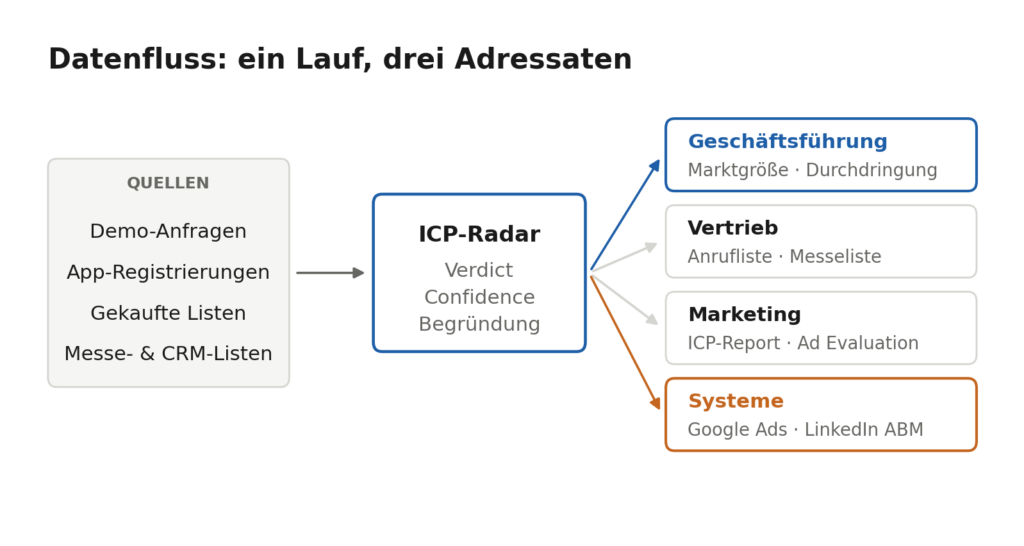
Von der strategischen Frage nach unten in den Kanal. Werbebudget ist die letzte Anwendung, nicht die erste.
| Prozess | Vorher | Jetzt | Nutzen |
|---|---|---|---|
| Marktforschung | Marktgröße geschätzt | alle Datenbanken dedupliziert und klassifiziert | gezählte Marktkarte: ~2/3 Primary, ~1/3 Secondary — Nenner für jede Durchdringungsrechnung |
| ICP-Report | Relevanz erst mit Sales-Feedback | monatliche Quote aus derselben Regel | Marketing-Steuerung ohne Wartezeit |
| Vertriebsdatenbank | Priorisierung nach Gefühl | gesamte Firmenliste vorsortiert | höhere Trefferquote ohne Änderung am Vertriebsprozess |
| Messevorbereitung | 700 Namen, keine Information | Website, Tätigkeitsfeld, ICP-Fit pro Zeile | gezielte Gespräche statt Hallendurchlauf |
| Produkt-Onboarding | Registrierungen von Hand geprüft | klare Fälle laufen durch | Handarbeit nur noch beim Rest |
| Cost per relevant Lead | belastbar nach ~4 Wochen | belastbar nach 1–1,5 Wochen | halbierte Blindflugzeit pro Kampagne |
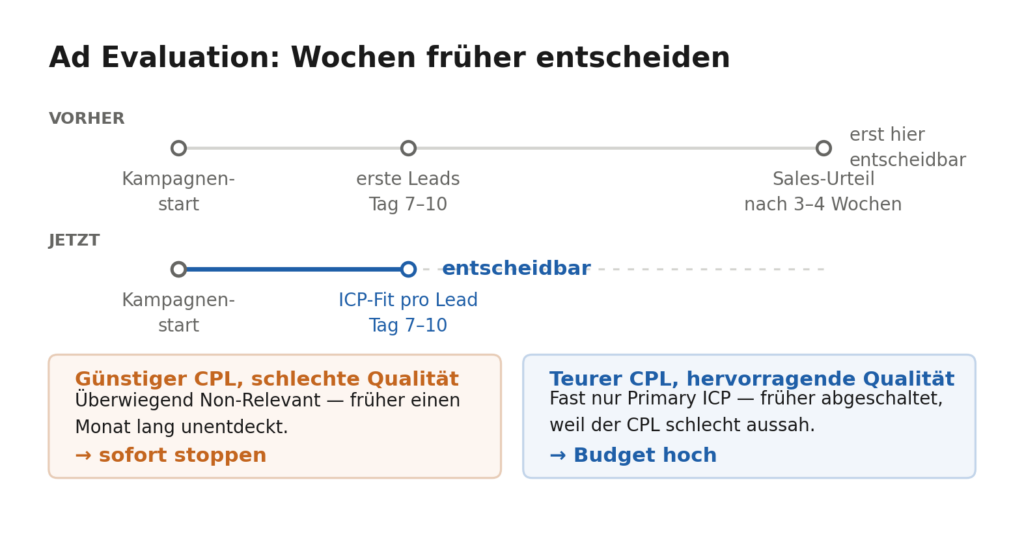
| Ad Evaluation | Qualität einer Anzeige erst nach Offline-Conversions und Sales-Gesprächen | Qualitätsprofil pro Anzeige ab den ersten Leads | schlechte Anzeige sofort stoppen, teure mit hohem Primary-Anteil bewusst weiterlaufen lassen |
| Retraction Google Ads | irrelevante Leads trainieren den Algorithmus | Non-Relevant wird automatisch zurückgezogen | Gebotsalgorithmus lernt nur auf die Zielgruppe |
| ABM auf LinkedIn | Zielgruppe nach Branchenfiltern | Primary + Secondary als Company-Liste | ~15 % größere Zielgruppen ohne Aufweichung |
Vier davon verdienen mehr als eine Tabellenzeile:
Marktforschung ist die Stelle, an der ein Marketing-Werkzeug aufhört, eines zu sein. Marktgröße ist eine Geschäftsführungszahl — hier fällt sie als Nebenprodukt an, aus derselben Regel, die operativ jeden eingehenden Lead einstuft. Marktzahl und Tagesgeschäft laufen zum ersten Mal synchron.
Cost per relevant Lead ist der größte operative Hebel. Vorher: Kampagne startet, erste Demo-Anfragen nach anderthalb Wochen, Offline-Conversions später, belastbare Aussage frühestens nach einem Monat. Jetzt steht die Relevanz, bevor die erste Rechnung kommt.
Ad Evaluation dreht die wichtigste Bewertung um. Vorher musste man Wochen warten, bis Offline-Conversions eintrudelten und der Vertrieb nach den Gesprächen sagen konnte, ob die Leads taugen. Jetzt liest man das Qualitätsprofil einer Anzeige an ihren ersten Leads ab — und zwar in beide Richtungen:
- Eine Anzeige mit gutem CPL, die überwiegend Non-Relevant liefert, fliegt sofort raus statt nach einem Monat.
- Eine teure Anzeige, die fast nur Primary bringt, bekommt mehr Budget statt abgeschaltet zu werden, weil der CPL schlecht aussah.
Der zweite Fall ist der wertvollere. Genau diese Anzeigen sterben in jedem Account, der nur auf Kosten pro Lead schaut.
Messevorbereitung war der Fall aus dem Intro — und der Beweis, dass die Definition die Marketing-Abteilung verlassen hat.
Der Beleg: AI vs. Humans
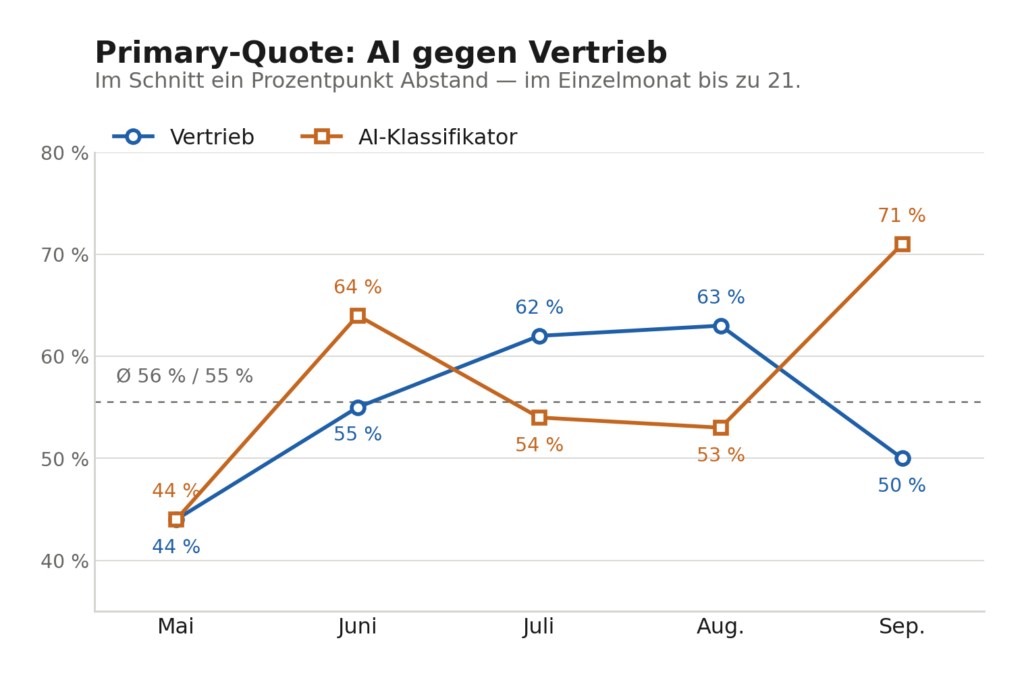
Fünf Monate, beide Seiten haben dieselben Leads unabhängig eingestuft.
| Monat | Vertrieb Primary | AI Primary |
|---|---|---|
| Mai | 44 % | 44 % |
| Juni | 55 % | 64 % |
| Juli | 62 % | 54 % |
| Aug. | 63 % | 53 % |
| Sept. | 50 % | 71 % |
| Ø gesamt | 56 % | 55 % |
Die kurze Antwort: Ja — im Schnitt ein Prozentpunkt Abstand, im Einzelmonat bis zu 21 Punkte in beide Richtungen.
Die Abweichung hat eine Richtung: 20 % Non-Relevant bei der AI, 11 % beim Vertrieb. Das Modell ist konservativer, es wirft im Zweifel weg, was ein Mensch noch mitnimmt. Für Budgetsteuerung ist das die richtige Richtung.
Wie entschieden wird
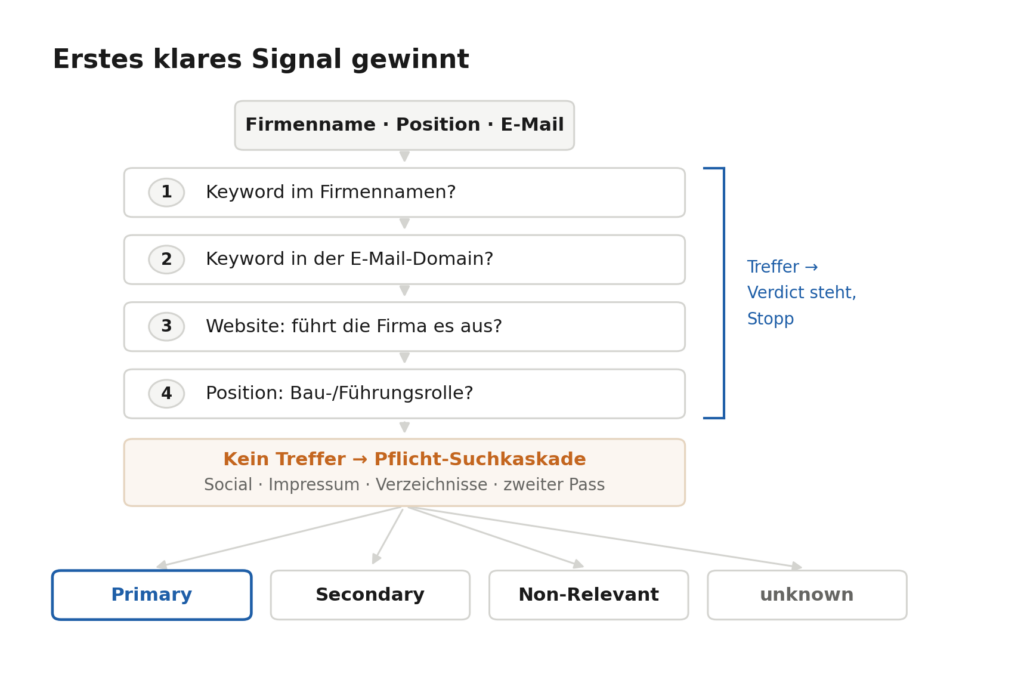
Kein Scoring-Modell, eine Reihenfolge: Firmenname → E-Mail-Domain → Website → Position als Tiebreaker. Erstes klares Signal gewinnt. Die Trennfrage ist nicht „ist das der Schwerpunkt der Firma?“, sondern „führt sie die Leistung selbst aus?“ — eine Sparte neben drei anderen reicht.
Zwei Mechanismen tragen die Qualität:
- Keyword-Gate. Steht ein Kern-Keyword im Namen, in der Domain oder in der eigenen Begründung des Modells, darf das Verdict nicht unter Primary liegen. Entstanden aus dem teuersten Fehler: Das Modell nannte das Keyword selbst — und stufte trotzdem herunter, Argument „breites Portfolio“. Acht Leads eines Bestandskunden.
- Nie raten. Ohne Beleg nach Pflicht-Suchkaskade und Zweitpass steht
unknown. Ein geratenes Primary ist teurer als ehrliches Nichtwissen — es verwässert den Report, und dann traut niemand mehr den Zahlen.
Kalibriert mit dem CEO — der eigentliche Teil der Arbeit
Version 1 war eine Regelliste aus dem Bauchgefühl. Sie war schlechter als Raten. Was daraus etwas Brauchbares gemacht hat, waren vier Kalibrierungsrunden gemeinsam mit dem CEO des Unternehmens — und das ist kein Höflichkeitssatz, sondern der Grund, warum das Ding heute firmenweit benutzt wird.
Der Ablauf pro Runde war immer derselbe:
- Einen Batch echter Leads durch die AI laufen lassen.
- Die Einstufung des Vertriebs danebenlegen.
- Nur die Abweichungen ansehen — in beide Richtungen: zu großzügig und zu streng.
- Pro Abweichung entscheidet der CEO, was richtig ist. Nicht das Marketing, nicht das Modell.
- Die Entscheidung geht als benannte Regel mit Belegfall in die Datei, nicht als Beispiel in einen Prompt.
Dabei kamen Regeln heraus, auf die das Marketing allein nie gekommen wäre:
| CEO-Verdikt | Was sich dadurch änderte |
|---|---|
| Die Trennfrage ist nicht „ist das der Schwerpunkt?“, sondern „führt die Firma die Leistung selbst aus?“ | Firmen mit der Leistung als eine Sparte neben drei anderen sind Primary statt Secondary — eine ganze Kundenklasse war vorher falsch einsortiert |
| Wer die Leistung beauftragt oder betreibt, ist Secondary — nie Non-Relevant | Behörden, Kommunen und Netzbetreiber wurden aussortiert, obwohl sie nachweislich kaufen |
| Ein Keyword in der eigenen Begründung des Modells sticht jedes Gegenargument | beendete die Klasse von Fehlern, bei denen das Modell sich selbst widersprach |
Inzwischen stehen 27 solcher benannten Korrekturen in der Datei. Sie sind der eigentliche Wert — die Grundregeln schreibt jeder in einer Stunde.
Und sie sind der Grund, warum die Definition trägt: Ein Klassifikator, den das Marketing allein kalibriert, ist eine Marketing-Meinung in Codeform. Erst wenn die Geschäftsführung jeden strittigen Fall entschieden hat, ist es eine Firmendefinition — eine, auf die sich Vertrieb und Geschäftsführung stützen können, ohne sie zu hinterfragen. Genau deshalb fragen sie das Werkzeug inzwischen von sich aus an.
Was das belegt — und was nicht
- Belegt: dieselbe Primary-Quote wie der Vertrieb, Wochen früher. Genug für Budget-Entscheidungen.
- Nicht belegt: dass dieselben Leads gleich eingestuft werden. 71 % gegen 50 % im September ist keine Übereinstimmung, auch wenn der Schnitt stimmt.
- Dünne Stichprobe: 13 Leads im September. Ein Grenzfall bewegt die Quote um acht Punkte.
- Der Vertrieb ist Maßstab, nicht Wahrheit. Der saubere Test wären Abschlussquoten nach AI-Einstufung über zwölf Monate.
- Marktkarte: gezählt sind die Firmen aus unseren Quellen, nicht alle am Markt. Belastbare Untergrenze, keine amtliche Marktgröße.
- Retraction und ABM: kein Performance-Nachweis. Plausibel, aber ungemessen — dafür bräuchte es einen Holdout, den das Volumen nicht hergibt.
Actions
- Erst Fehlerklassen sammeln, dann Regeln schreiben. Hundert Leads von Hand einstufen, AI danebenlegen, nur Abweichungen ansehen.
- In beide Richtungen prüfen. Wer nur False Positives ansieht, baut ein Modell, das alles wegwirft.
- Begründung und Confidence erzwingen. Ohne beides kein Review, ohne Review keine nächste Version.
unknownals vollwertiges Ergebnis behandeln. Der Anteil ist eine Kennzahl, kein Makel.- Nur mit hoher Confidence automatisieren, den Rest vorschlagen.
- Die fertige Definition auf die Altbestände werfen. Derselbe Rechenlauf ergibt Marktgröße, Vertriebsliste und ABM-Zielgruppe — drei Abteilungen, ein Lauf.
Der Aufwand: eine Regeldatei, vier Kalibrierungsrunden, ein tägliches Script. Der Ertrag lag woanders als erwartet. Die Kanal-Optimierung war der Anlass — geblieben ist, dass „unsere Zielgruppe“ eine überprüfbare, versionierte Definition ist statt einer Meinung pro Abteilung. Und dass andere Abteilungen damit arbeiten, ohne das Marketing zu fragen.